「計量計測データバンク」サイトマップ measure and measurement data bank of saite map
計量計測データバンク ニュースの窓-439-
├
├計量計測データバンク ニュースの窓-439-Claudeは中央集権的・恒久的な自己蓄積型の情報源を持たず、静的な学習コーパスと動的な外部ツール・記憶機構を組み合わせる設計で動作する
├
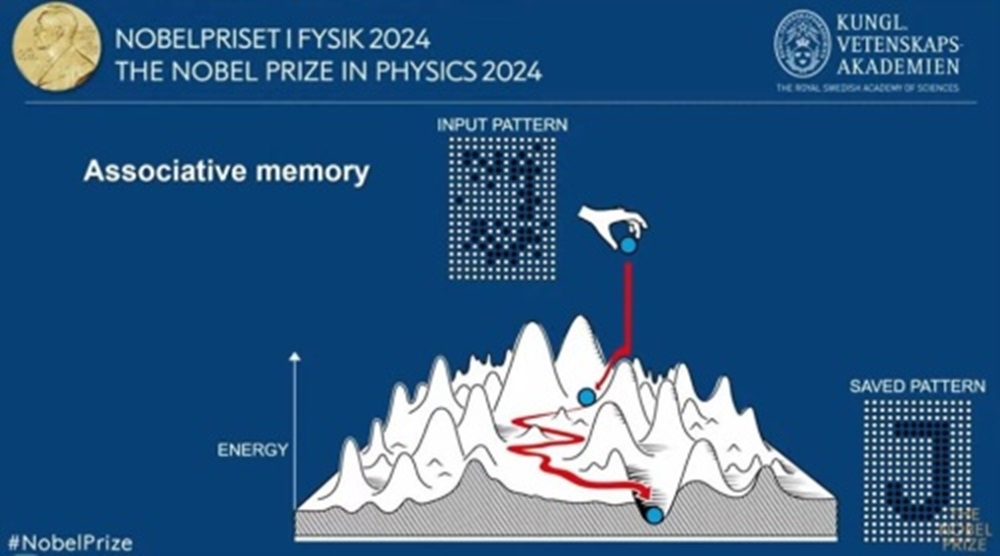
ホップフィールド・ネットワーク - Wikipedia ホップフィールド・ネットワーク (英: Hopfield network) は、ニューラルネットワークの一モデルである。アメリカ合衆国の物理学者であるジョン・ホップフィールド
(J.J. Hopfield) が提唱した。ユニット(ニューロン)間に対称的な相互作用がある非同期型ネットワークであり、自然な操作によってネットワークのエネルギーが極小値をとる。元はスピンの安定条件をもとめるモデルとして発想されたものであったが、ネットワークによる連想記憶のモデルとして歓迎され、ニューラルネットブームの火付け役の一つとなり、また後のボルツマンマシンの元ともなった。これは統計的な変動をもちいて、エネルギーが極小値ではなく最小値をとることを目指すモデルである。
2024年ノーベル物理学賞は、「人工ニューラルネットワークによる機械学習を可能にした基礎的発見と発明に対する業績」によりJohn J. Hopfield
氏(プリンストン大学、アメリカ)、Geoffrey E. Hinton 氏(トロント大学、カナダ)の2氏が受賞
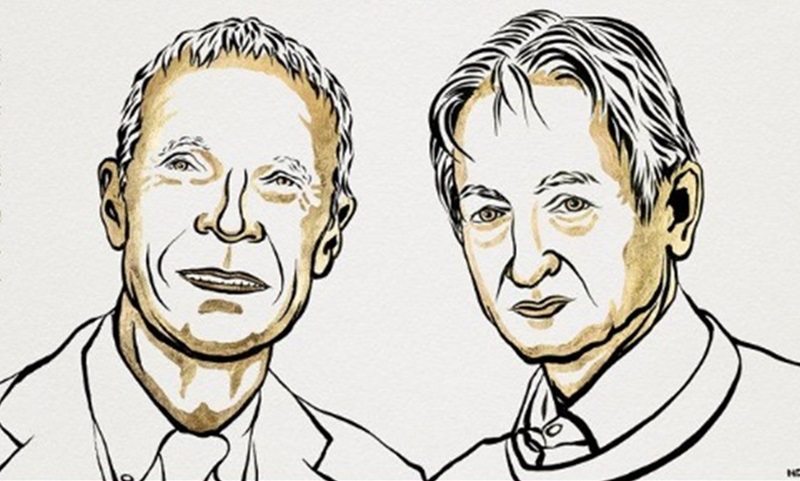
写真左はJohn J. Hopfield(ホップフィールド)氏、右はGeoffrey E. Hinton(ヒントン)氏。2024年ノーベル物理学賞 人工ニューラルネットワークによる機械学習を可能にする基礎的発見と発明(ジョン・ホップフィールドとカナダのトロント大学のジェフリー・ヒントン)
対話型人工知能Claudeの情報検索方法と情報源蓄積、検索能力の現状・限界・将来展望
著者:横田俊英(計量計測データバンク)
要旨
本稿は、対話型人工知能Claudeの情報検索の仕組みを、内部知識・外部ツール・記憶機構の三層から整理し、独自情報源の蓄積状態、検索能力の到達点と限界、そして将来の展望を論じる。Claudeは中央集権的な自己蓄積型データベースを持たず、事前学習コーパスとセッション単位の外部接続を組み合わせて動作する設計であり、この特性が現状の強みと限界の双方を規定している。
1. はじめに
生成AIの利用が社会に浸透する中で、対話型人工知能がどのように情報を検索し、何を情報源としているのかは、利用者にとって十分に理解されているとは言い難い。Anthropic社が開発するClaudeは、自然言語による対話を通じて質問応答や文書作成を支援する代表的な対話型人工知能の一つである。
本稿では、Claudeの情報検索方法を整理したうえで、独自情報(情報源)の蓄積状態を検討し、情報検索能力の現状とその限界、さらに将来の可能性について考察する。構成は次の通りである。第2章でClaudeの情報検索方法を、第3章で情報源の蓄積状態を、第4章で検索能力の現状を、第5章でその限界を、第6章で将来の可能性を論じ、第7章で結論を示す。
2. Claudeの情報検索方法
Claudeが用いる情報検索の経路は、大きく四つに整理できる。
第一は、事前学習によってモデルの重みに内部化された知識である。これは大量のテキストデータから統計的パターンを学習したものであり、特定の時点(知識カットオフ)以降の出来事は反映されていない。
第二は、Web検索ツールによる外部検索である。Claudeは最新情報、変動する数値、人物・組織・製品に関する情報など、内部知識だけでは対応できないと判断した場合に自動的にWeb検索を実行し、必要に応じて複数回の検索を繰り返す。検索結果には出典のURL、タイトル、該当箇所の引用文(cited_text)が構造化データとして付与され、回答の末尾に出典として明示する仕組みが用意されている。
第三は、Model Context Protocol(MCP)を介した外部システムとの接続である。MCPは「AIアシスタントをデータが存在するシステムに接続するオープン標準」としてAnthropic社が公開したもので、Slack、GitHub、Google
Driveなど個別のシステムごとに専用の実装を用意する代わりに、共通プロトコルでデータソースを統合できるようにする。
第四は、ユーザーが提供する文書やファイルの直接読み込みである。アップロードされた資料の内容を読み取り、その場で提示された情報を検索・参照の対象とする。
3. 独自情報(情報源)の蓄積状態
Claudeが保持する「情報源」の性質は、一般的なデータベースとは異なる。
第一に、事前学習コーパスは個別の事実を検索可能な形で保存したものではなく、大量の公開テキストから抽出された統計的パターンとしてモデルの重みに溶け込んでいる。そのため、特定の出典を後から一件ずつ引き出すことはできず、知識カットオフ以降の情報は原理的に含まれない。
第二に、ProjectsやArtifactsといった機能は、特定の作業やユーザーに固有の文脈を一時的に保持する仕組みであり、モデル自体の恒久的な知識として蓄積されるものではない。
第三に、メモリーツールは/memoriesディレクトリへの読み書きを通じて、複数セッションにまたがる進捗状況や過去のやり取りから得た決定事項を記録できる仕組みだが、その永続化先(ローカルファイル、データベース、クラウドストレージ等)はClaudeを利用するアプリケーション側のインフラストラクチャに委ねられており、Claude自身が自律的に情報を蓄積し続ける恒久記憶を備えているわけではない。パストラバーサル対策や機密情報の自動検証・削除など、セキュリティ上の制約も課されている。
第四に、Skillsと呼ばれる手順知識のパッケージは、特定分野のベストプラクティスを都度読み込んで参照する仕組みであり、モデルの内部知識として恒久的に統合されるものではない。
総じて、Claudeは中央集権的・恒久的な自己蓄積型の情報源を持たず、事前学習コーパスという静的な基盤と、セッションごとに接続される外部ツール・記憶機構という動的な要素を組み合わせる設計思想に立っている。
4. 情報検索能力の現状
現状のClaudeは、単純なキーワード検索の域を超え、エージェント的な多段階の調査能力を備えている。
プロンプトの内容から検索の要否を自動的に判断し、必要であれば複数回にわたってWeb検索を実行しながら、得られた結果を吐味し、不足があれば追加の検索を行う。ファイルの読み込み、コードの実行、MCP経由での外部データ取得といった複数のツールを組み合わせることで、単一の情報源に依存しない横断的な調査が可能になっている。
MCPを通じてSlack、Google Drive、GitHubといった業務システムに接続すれば、組織内部の文書やデータを検索対象に含めることもできる。また、Web検索の結果には出典URLと引用文が自動的に付与される仕組みが備わっており、回答の検証可能性を一定程度確保している。
こうした機能を総合すると、Claudeの情報検索能力は、断片的な事実の取得にとどまらず、複数ステップにわたる調査・要約・出典明示までを一括して担える段階に達していると言える。
5. 情報検索能力の限界
一方で、Claudeの情報検索能力にはいくつかの明確な限界が存在する。
第一に、ハルシネーション(文脈と矛盾する、あるいは事実に基づかない文章を生成する現象)のリスクが残る。Anthropic社自身のガイドラインも、不確実性を許容する指示や直接引用に基づく分析、複数回の実行による検証といった低減策を推奨する一方で、これらの手法をもってしてもハルシネーションを完全には排除できないと明記している。
第二に、知識カットオフ以降の空白である。事前学習コーパスに基づく内部知識は特定の時点で更新が止まっており、それ以降の出来事はWeb検索など外部ツールに頼らない限り把握できない。
第三に、検索対象・地域の制約である。Web検索機能の提供地域には制限があり、また認証が必要な非公開ページやログインを要するサービスの内容は直接取得できない。
第四に、一次情報の真正性検証の難しさである。検索結果自体の信頼性は検索エンジンや掲載元に依存しており、Claudeが独自に情報源の真偽を確定できるわけではない。
第五に、リアルタイム性と網羅性の限界である。検索結果は外部の検索インデックスのクロール頻度や範囲に依存するため、極めて速報性の高い情報や、インデックスされていない情報には対応できない場合がある。
第六に、プライバシーとセキュリティ上の制約である。メモリー機能はパストラバーサル対策や機密情報の自動検証・削除といった制御下に置かれており、情報を無制限に蓄積・参照できる設計にはなっていない。
6. 将来の可能性
今後の発展として、いくつかの方向性が展望できる。
第一に、検索拡張生成(RAG)の高度化である。検索結果をより細かい単位で根拠づけ、生成内容と出典の対応関係をさらに精密化することで、回答の検証可能性を高める余地がある。
第二に、個人・組織単位での永続的な知識基盤との統合である。メモリーツールやコンテキスト編集・圧縮技術の発展により、長期にわたるセッションでも文脈を維持しながら、利用者固有の知識を蓄積・活用できる仕組みが整いつつある。
第三に、複数エージェントの協調による検証精度の向上である。ある回答を別のエージェントが裏付け確認する、あるいは複数の経路で得た情報を突き合わせるといった仕組みにより、単一の検索結果に依存するリスクを減らすことが期待できる。
第四に、出典明示の一層の強化である。Web検索結果への引用付与はすでに標準機能となっているが、これをより多様なツール・データソースに拡張し、Anthropic社が公開する透明性レポートのような形でモデルの挙動を継続的に説明する取り組みも重要性を増すと考えられる。
第五に、MCPエコシステムの拡充による専門分野特化コネクタの充実である。業界固有のデータソースとの接続が容易になることで、より専門性の高い分野における情報検索の質が向上する可能性がある。
7. 結論
本稿では、対話型人工知能Claudeの情報検索方法を、事前学習による内部知識、Web検索ツール、MCPを介した外部接続、そして文書の直接読み込みという四つの経路から整理した。そのうえで、Claudeが中央集権的・恒久的な自己蓄積型の情報源を持たず、静的な学習コーパスと動的な外部ツール・記憶機構を組み合わせる設計に立っていることを確認した。
現状の検索能力は、複数ステップにわたる調査・要約・出典明示を一括して担える水準に達している一方で、ハルシネーションのリスク、知識カットオフ以降の空白、検索対象の制約、真正性検証の困難さといった限界も同時に抱えている。
これらの限界は、RAGの高度化、永続的知識基盤との統合、複数エージェントによる検証、出典明示の強化、専門分野特化コネクタの拡充といった方向性によって、今後段階的に緩和されていくことが見込まれる。対話型人工知能を実務に活用するうえでは、こうした仕組みと限界の双方を理解したうえで、出力を鵜呑みにせず検証する姿勢が引き続き求められる。
参考文献
├
├計量計測データバンク ニュースの窓-420-AI(人工知能)モデルを理解する(AIモデル比較、ランキング、AIモデルとは、主要なAIモデルなど)-
├計量計測データバンク ニュースの窓-421-生成AIの仕組み 生成AIと従来のAIとの違い 生成AIをビジネス(仕事)に導入する3つのメリット 代表的なテキスト生成AI ChatGPT、Claude、Geminiの3つ
├計量計測データバンク ニュースの窓-423-生成AI導入の実際の方法(コンサルタント支援を受けるなど支援の実態事例と費用など)
├計量計測データバンク ニュースの窓-437-対話型AIのClaudeは利用者の傾向を把握し、調査探索の深度上がり、文体・語彙・構成も熟練度を増す
├計量計測データバンク ニュースの窓-439-Claudeは中央集権的・恒久的な自己蓄積型の情報源を持たず、静的な学習コーパスと動的な外部ツール・記憶機構を組み合わせる設計で動作する
├計量計測データバンク ニュースの窓-450-対話型人工知能ClaudeほかAIは、収集情報への連結と弁証法的知能活動によって、アインシュタイン的な未知への切り込みは今のところ苦手とする
├2024ノーベル 化学賞はAIでたんぱく質の立体構造予測と新たんぱく質設計の研究者ら(デビッド・ベイカー、デミス・ハサビス、ジョン・ジャンパー)
├2024年ノーベル物理学賞 人工ニューラルネットワークによる機械学習を可能にする基礎的発見と発明(ジョン・ホップフィールドとカナダのトロント大学のジェフリー・ヒントン)
├
TOPへ
├
├計量計測データバンク ニュースの窓 目次
├
2026-09-02-news-439-materia-content-collection-of-metrology-databank-439-
「計量計測データバンク」サイトマップ
measure and measurement data bank of saite map